Análisis de la evolución de los datos en la era de la inteligencia artificial
21 de Octubre de 2026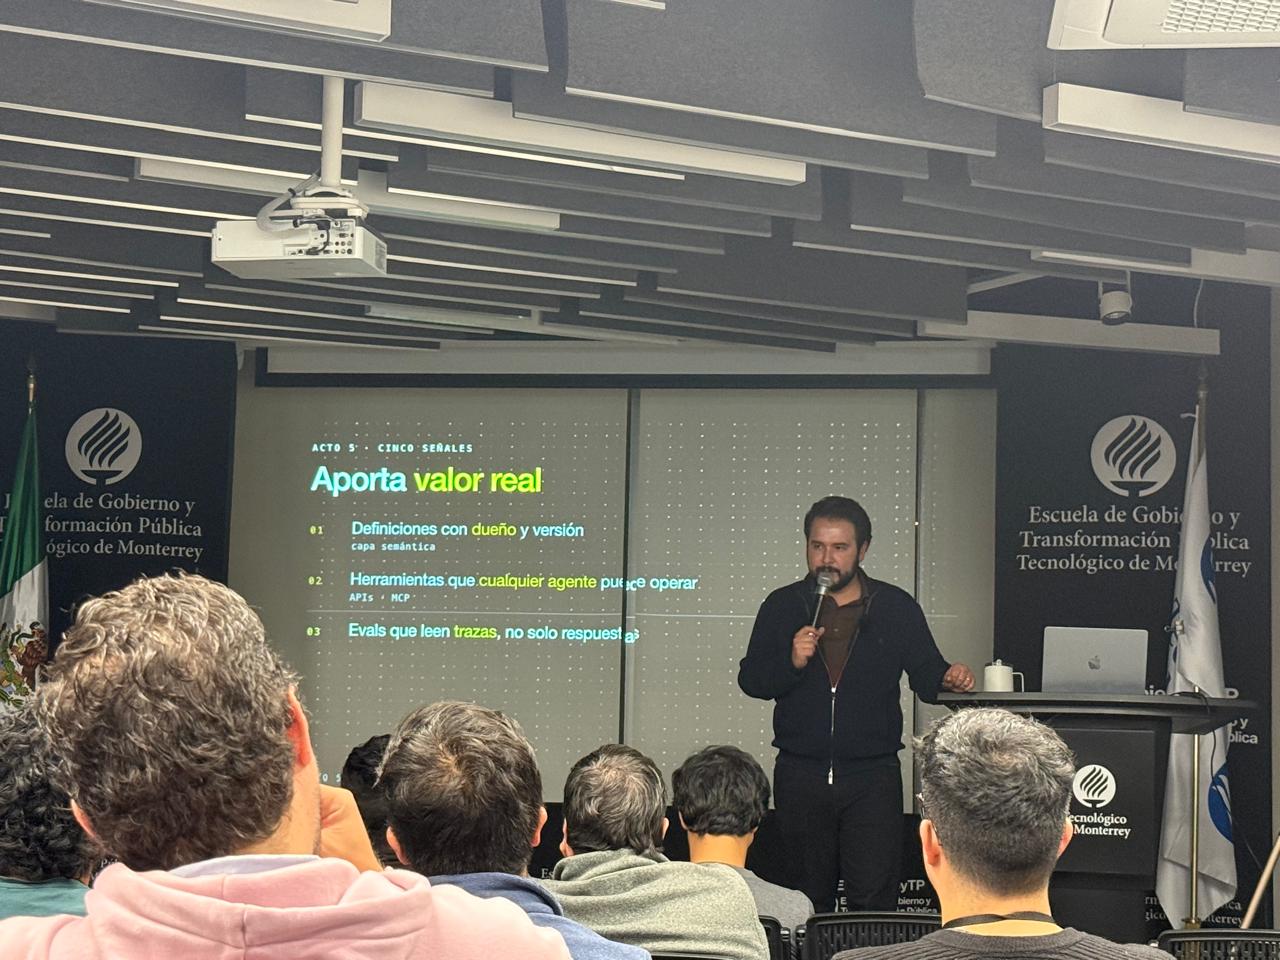
Este 21 de octubre de 2026 tuvimos una nueva sesión de The Data Pub, encuentro dedicado al intercambio de conocimientos sobre ingeniería de datos, inteligencia artificial y tecnologías emergentes.
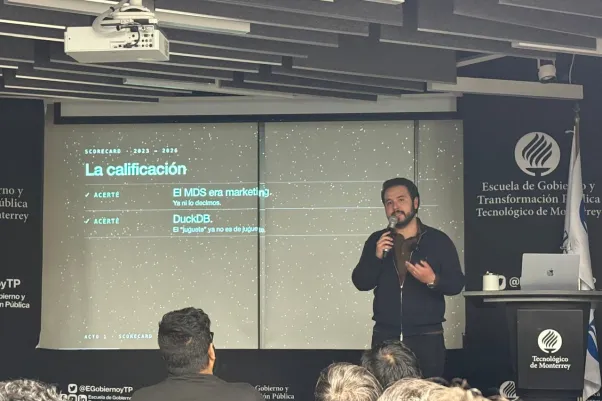
Bajo el título “Post-AI Data Stack: ¿Qué cambió en la era de GPT?”, Carlos Alberto Haro, AI Engineer en Santander México, presentó una revisión de la evolución del ecosistema de datos y los desafíos que enfrenta ante la creciente incorporación de herramientas de inteligencia artificial.
La charla retomó una conversación iniciada en 2023 sobre el denominado Modern Data Stack, conjunto de herramientas y tecnologías utilizadas para recopilar, transformar, almacenar y analizar información.
Tres años después, la expansión de los modelos de lenguaje, las arquitecturas para aplicaciones de IA y los agentes inteligentes ha abierto nuevas preguntas sobre la infraestructura tecnológica que requieren las organizaciones.
De los sistemas tradicionales a la era post-IA
Durante su presentación, Haro expuso cuatro etapas en la evolución de las arquitecturas de datos: los sistemas previos a la modernización, el almacenamiento en la nube, el Modern Data Stack y el nuevo escenario post-IA.
Este recorrido permitió observar cómo las necesidades de las organizaciones han pasado de centralizar información y generar reportes a desarrollar infraestructuras más flexibles, capaces de facilitar la operación de sistemas inteligentes.
Uno de los planteamientos centrales fue el cambio en la relación entre los datos y quienes los utilizan: mientras que anteriormente gran parte del trabajo se concentraba en producir reportes, las nuevas arquitecturas apuntan hacia sistemas que permiten operar sobre la información y aprovecharla en procesos cada vez más automatizados.
En este contexto, el especialista también examinó la evolución de tecnologías como DuckDB y dbt, así como los cambios en las expectativas sobre los tiempos y la complejidad de las migraciones tecnológicas.
Nuevos desafíos para la ingeniería de datos
Otro de los temas abordados fue la complejidad que implica responder preguntas de negocio a partir de información distribuida en diferentes sistemas.
Mediante ejemplos sobre el recorrido de los datos —desde sus fuentes originales hasta su transformación, modelado y análisis—, se ilustró cómo una consulta aparentemente sencilla puede requerir múltiples procesos técnicos.
La presentación incluyó una comparación ilustrativa entre procesos que pueden involucrar varios meses de trabajo y equipos especializados, frente a actividades que, una vez preparada la infraestructura correspondiente, pueden ejecutarse en periodos mucho más breves.
Estos ejemplos permitieron poner sobre la mesa una cuestión relevante para las organizaciones: cómo aprovechar las nuevas herramientas tecnológicas para reducir la complejidad de sus procesos sin comprometer la calidad y confiabilidad de la información.
Más allá de las tendencias tecnológicas
La sesión también invitó a reflexionar sobre la necesidad de distinguir entre las innovaciones que generan beneficios concretos y aquellas que responden principalmente al entusiasmo que rodea a la inteligencia artificial.
La expansión de tecnologías como los modelos de lenguaje, la búsqueda vectorial y los agentes de IA plantea nuevas posibilidades para el uso de datos, pero también exige revisar las decisiones relacionadas con su arquitectura, integración y mantenimiento.
En ese sentido, la discusión destacó la vigencia de principios fundamentales de ingeniería, como el modelado, la calidad de los datos y las buenas prácticas de desarrollo.
La realización de este encuentro de The Data Pub contribuye a generar espacios de intercambio entre la comunidad tecnológica y el ámbito académico, en torno a las transformaciones que están redefiniendo el aprovechamiento de los datos y la inteligencia artificial.