Data Pub: Text to SQL en el contexto de agentes conversacionales
30 de Septiembre de 2026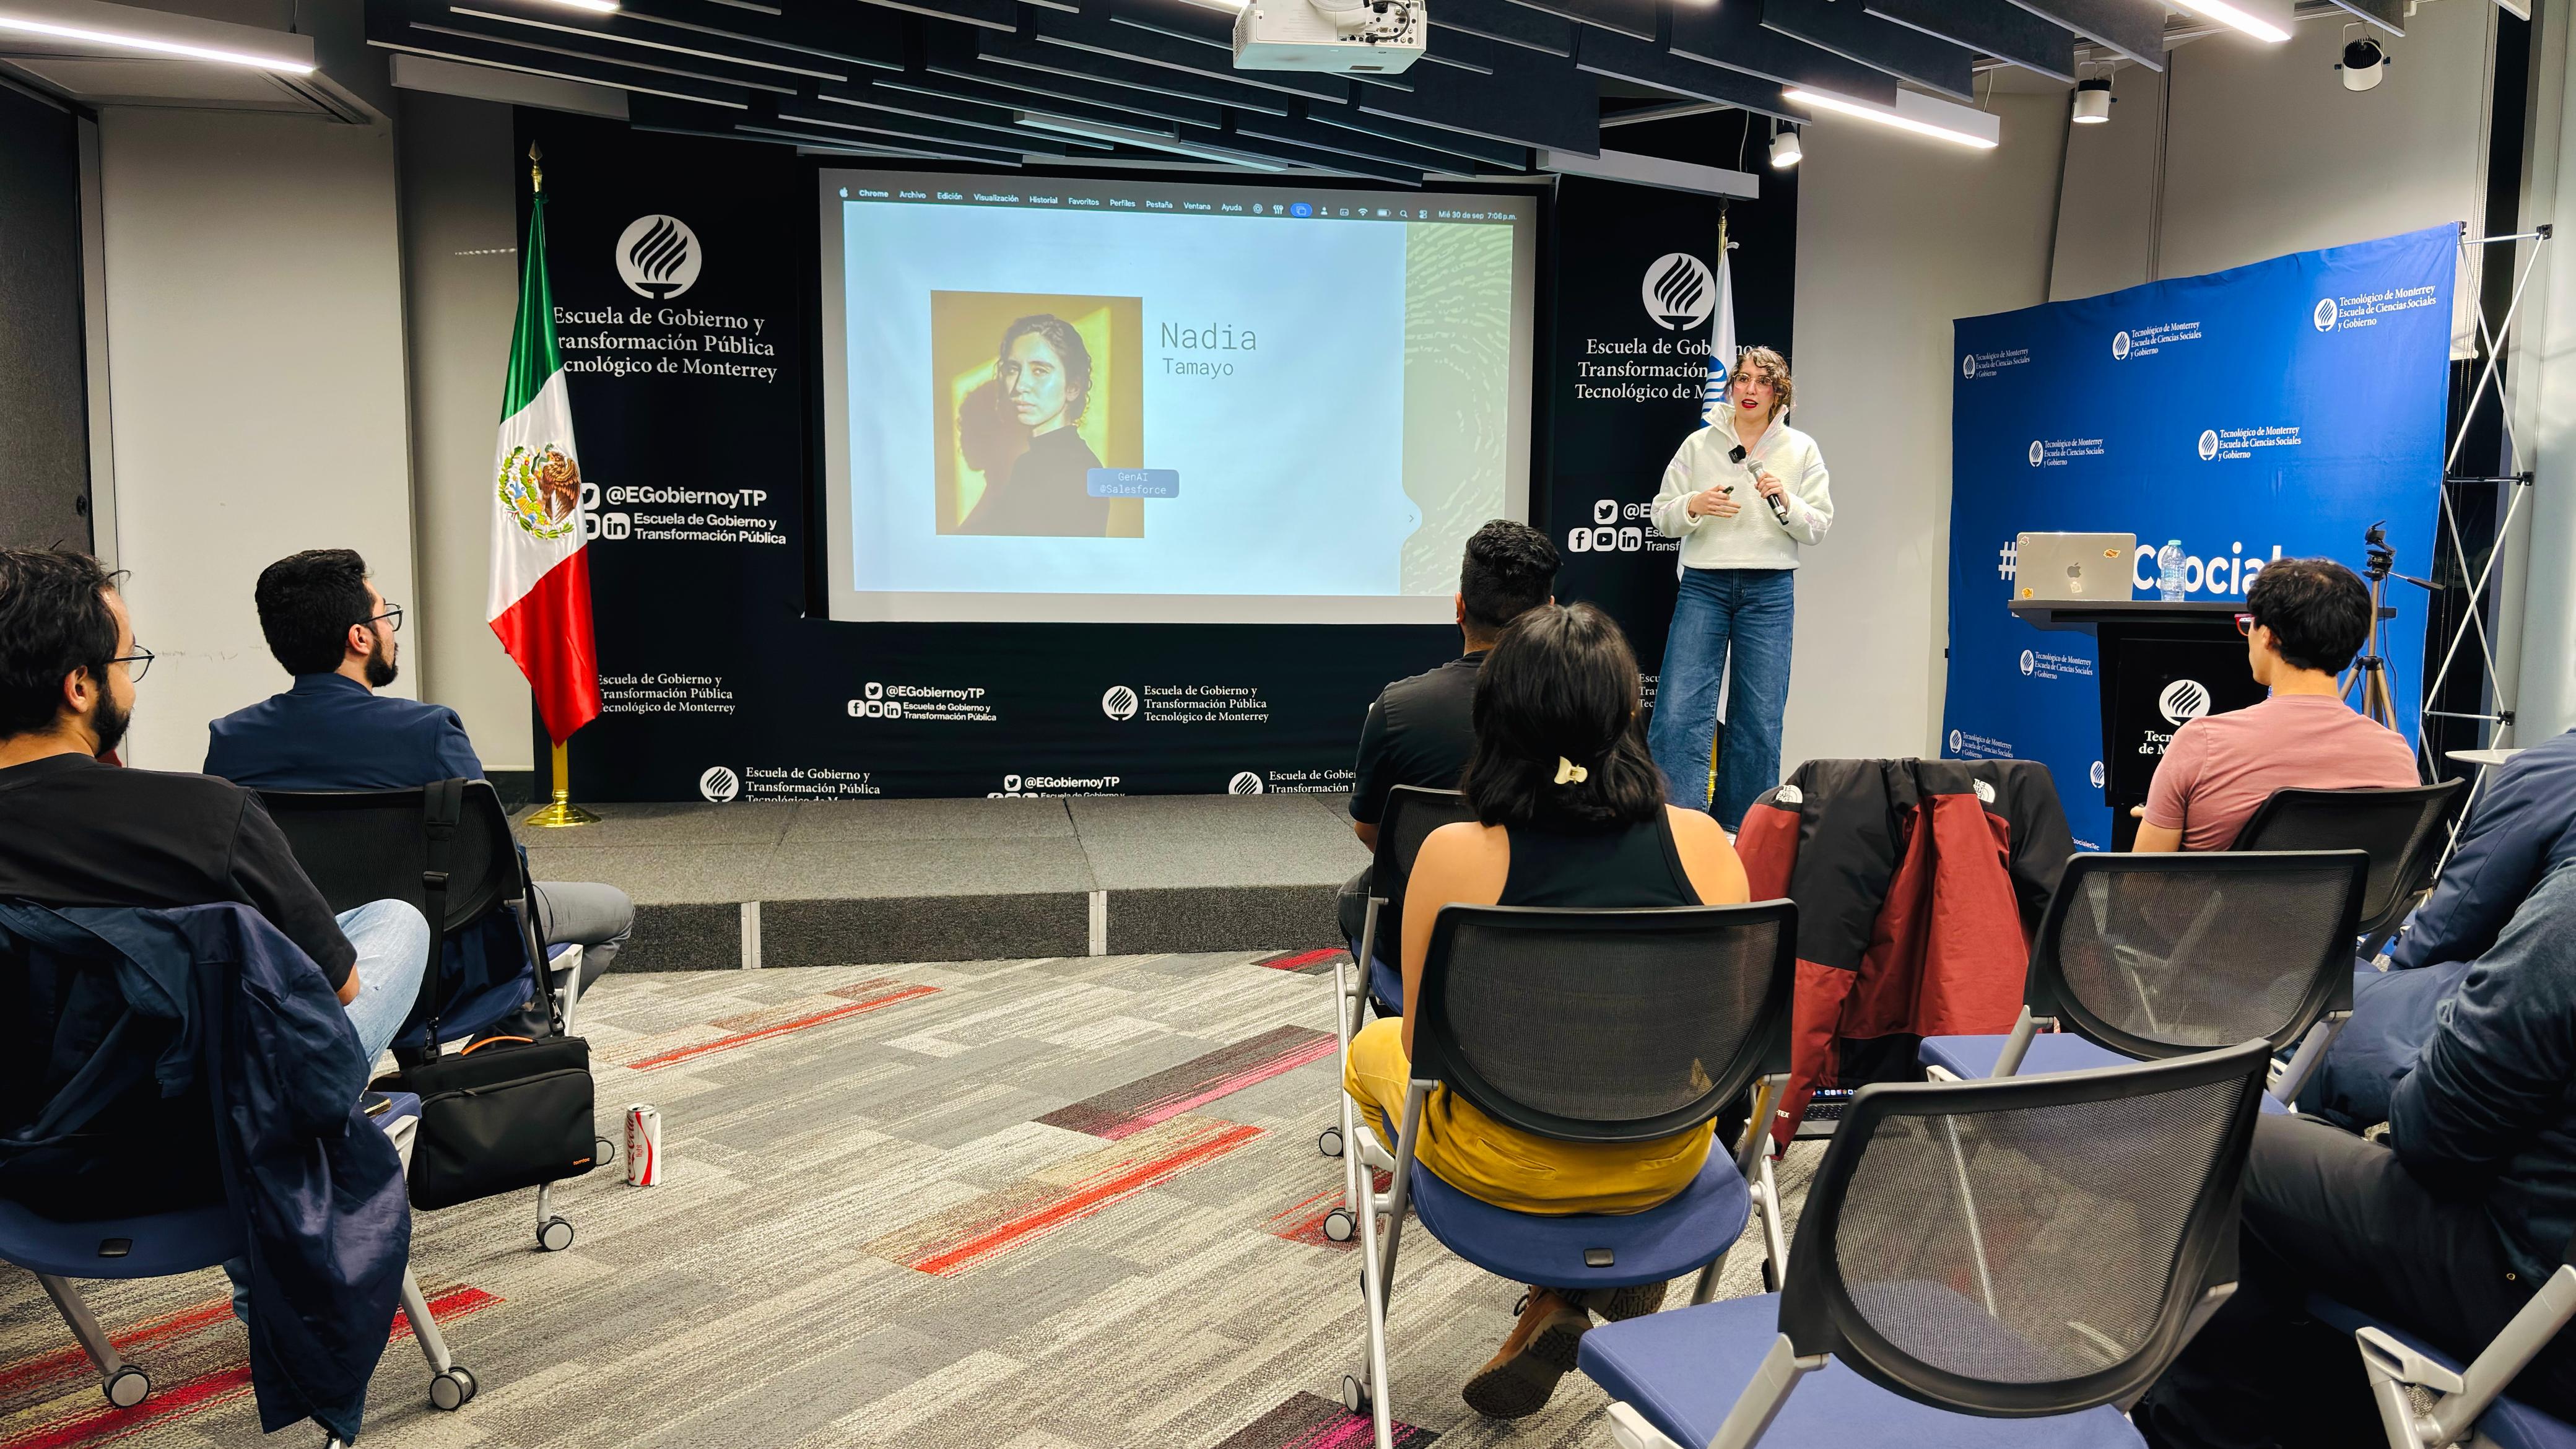
Este 30 de septiembre se llevó a cabo una nueva edición de The DataPub, con la presentación Text to SQL: en el contexto de agentes conversacionales, una sesión dedicada a analizar los avances, limitaciones y componentes tecnológicos necesarios para convertir preguntas formuladas en lenguaje natural en consultas SQL útiles para el análisis de datos.
La presentación partió de una promesa cada vez más relevante para organizaciones que trabajan con grandes volúmenes de información: permitir que una persona consulte una base de datos mediante una conversación, sin necesidad de conocer directamente su estructura ni escribir código SQL. Sin embargo, la sesión mostró que transformar esta idea en un sistema confiable implica resolver problemas que van mucho más allá de conectar un modelo de lenguaje con una base de datos.
Del lenguaje natural a un lenguaje estructurado
Uno de los principales retos abordados fue la diferencia entre el lenguaje natural y SQL. Mientras que una pregunta formulada por una persona puede ser ambigua, contextual e incluso incompleta, una consulta SQL requiere instrucciones precisas, estructuradas y compatibles con el esquema de una base de datos.
A esta dificultad se suma la complejidad de las estructuras de información utilizadas en contextos reales. Una misma organización puede trabajar con múltiples tablas, relaciones, convenciones de nomenclatura y transformaciones históricas, por lo que identificar correctamente qué datos deben utilizarse para responder una pregunta constituye una parte central del problema.
La presentación destacó, además, otros desafíos: controlar las alucinaciones de los modelos de lenguaje, garantizar la precisión de las consultas generadas y traducir conceptos propios del negocio —como margen, ventas netas o determinadas categorías de clientes— en métricas claramente definidas y reproducibles.
En este sentido, el reto de Text-to-SQL no consiste únicamente en producir una consulta sintácticamente válida, sino en generar una consulta que represente correctamente la intención de la pregunta y la lógica con la que una organización interpreta sus datos.
El “sueño dorado” de conversar con los datos
La sesión ilustró el escenario ideal de Text-to-SQL mediante una interacción conversacional en la que un usuario solicita información directamente en lenguaje natural y recibe no solo una respuesta basada en los datos, sino también elementos adicionales de análisis.
Este modelo representa una posible transformación en la manera en que las organizaciones acceden a la información. En lugar de depender exclusivamente de especialistas capaces de escribir consultas o construir reportes, una interfaz conversacional podría facilitar el acceso a indicadores y métricas por parte de usuarios con distintos niveles de conocimiento técnico.
Sin embargo, la presentación subrayó implícitamente una distinción fundamental: generar una respuesta plausible no equivale necesariamente a generar una respuesta correcta. Para alcanzar el nivel de confiabilidad requerido en contextos productivos es necesario incorporar mecanismos capaces de proporcionar al modelo información sobre la estructura de los datos, sus relaciones y, particularmente, su significado dentro del negocio.
Fine-tuning, contexto y recuperación de información
La presentación revisó distintas aproximaciones que se han utilizado para mejorar el desempeño de los sistemas Text-to-SQL.
Entre ellas se encuentra el fine-tuning, mediante el cual un modelo puede aprender patrones relacionados con la estructura de una base de datos y con la sintaxis SQL a partir de ejemplos de entrenamiento. Entre sus ventajas se destacó la posibilidad de incorporar conocimiento específico y reducir la dependencia de la ventana de contexto, aunque este enfoque también puede introducir mayor rigidez frente a cambios en los datos o en las necesidades del negocio.
Otra estrategia es el in-context learning, que consiste en proporcionar al modelo información y ejemplos directamente dentro del contexto de la interacción. Esta alternativa permite realizar pruebas e implementaciones con relativa rapidez, pero enfrenta limitaciones vinculadas con la cantidad de información que puede incluirse en el contexto y con su escalabilidad en entornos productivos.
La sesión también abordó el uso de Retrieval-Augmented Generation (RAG), una arquitectura en la que el modelo recupera información relevante antes de generar una respuesta. En el caso de Text-to-SQL, esta información puede incluir descripciones de tablas, columnas, métricas o documentación asociada con la base de datos. Este enfoque permite trabajar con conjuntos de información más amplios sin necesidad de reentrenar constantemente el modelo, aunque su desempeño depende de la calidad del sistema de recuperación y de la documentación disponible.
La capa semántica como vínculo entre datos y negocio
Uno de los elementos centrales de la presentación fue la capa semántica, concebida como un mecanismo para transformar estructuras técnicas de datos en conceptos comprensibles y métricas claramente definidas.
En lugar de obligar al modelo de lenguaje a inferir directamente el significado de tablas y columnas con nombres técnicos, la capa semántica puede exponer conceptos de negocio como ventas netas, margen de beneficio, clientes activos o periodos fiscales. De esta manera, funciona como una intermediación entre la forma en que se almacenan los datos y la forma en que las personas formulan preguntas sobre ellos.
La sesión señaló varias ventajas de este enfoque. En primer lugar, permite centralizar la lógica de negocio y establecer una única fuente de verdad para determinadas métricas. Esto reduce la posibilidad de que diferentes usuarios o sistemas utilicen definiciones distintas para un mismo indicador.
En segundo lugar, puede contribuir a disminuir errores tanto sintácticos como lógicos al restringir las consultas del modelo a una representación previamente estructurada y validada de los datos.
Finalmente, la capa semántica facilita la interpretabilidad. Si una consulta puede vincularse con una métrica de negocio previamente definida, resulta más sencillo rastrear cómo se produjo una respuesta y auditar las decisiones tomadas por un sistema basado en modelos de lenguaje.
El flujo presentado puede resumirse como una transición de conceptos a métricas y, posteriormente, a SQL, en lugar de pedir al modelo que interprete directamente cada detalle del esquema físico de la base de datos.
De un modelo aislado a arquitecturas de agentes
La sesión también situó Text-to-SQL dentro del desarrollo de las llamadas arquitecturas agénticas, en las que los modelos de lenguaje pueden interactuar con herramientas y distribuir tareas entre distintos componentes.
Se presentaron diferentes configuraciones. Una arquitectura de agente único concentra la interacción entre el modelo y distintas herramientas dentro de un mismo sistema. Las arquitecturas en red, en cambio, permiten que varios agentes intercambien información y colaboren en una tarea. Finalmente, las arquitecturas con supervisor incorporan un agente coordinador encargado de asignar o gestionar las actividades realizadas por otros agentes especializados.
Aplicadas a Text-to-SQL, estas arquitecturas abren la posibilidad de separar funciones como interpretar la pregunta del usuario, identificar las métricas relevantes, recuperar información sobre el esquema, generar la consulta, validarla y analizar posteriormente los resultados.
Este enfoque también modifica el problema original. La pregunta deja de ser únicamente cómo conseguir que un modelo escriba SQL y pasa a incluir cómo diseñar un sistema en el que diferentes componentes colaboren de manera controlada y verificable.
De generar SQL a construir sistemas confiables
La discusión presentada en The DataPub mostró que el desarrollo de Text-to-SQL se encuentra en la intersección entre modelos de lenguaje, ingeniería de datos, arquitectura de sistemas y conocimiento del negocio.
El potencial de estas herramientas radica en democratizar el acceso a los datos mediante interfaces más cercanas al lenguaje cotidiano. No obstante, su adopción en entornos reales requiere mecanismos que permitan controlar la precisión, definir claramente las métricas, reducir las alucinaciones y mantener trazabilidad sobre la manera en que se construyen las respuestas.
La sesión permitió así pasar de la idea aparentemente sencilla de “preguntarle a una base de datos en lenguaje natural” a una discusión más amplia sobre las condiciones necesarias para hacerlo de manera robusta. En este contexto, componentes como las capas semánticas, los sistemas de recuperación de información y las arquitecturas agénticas aparecen no solo como herramientas para generar consultas, sino como elementos de una infraestructura orientada a producir respuestas verificables, interpretables y alineadas con la lógica de una organización.